O pedido costuma chegar assim: a equipe de BI quer uma cópia da base de clientes para montar um painel, e alguém responde que vai mandar a base "anonimizada". Na prática, a coluna de nome vira um código, o CPF some e o resto continua lá: data de nascimento, CEP, bairro, histórico de compras. Para a LGPD, isso quase nunca é anonimização.
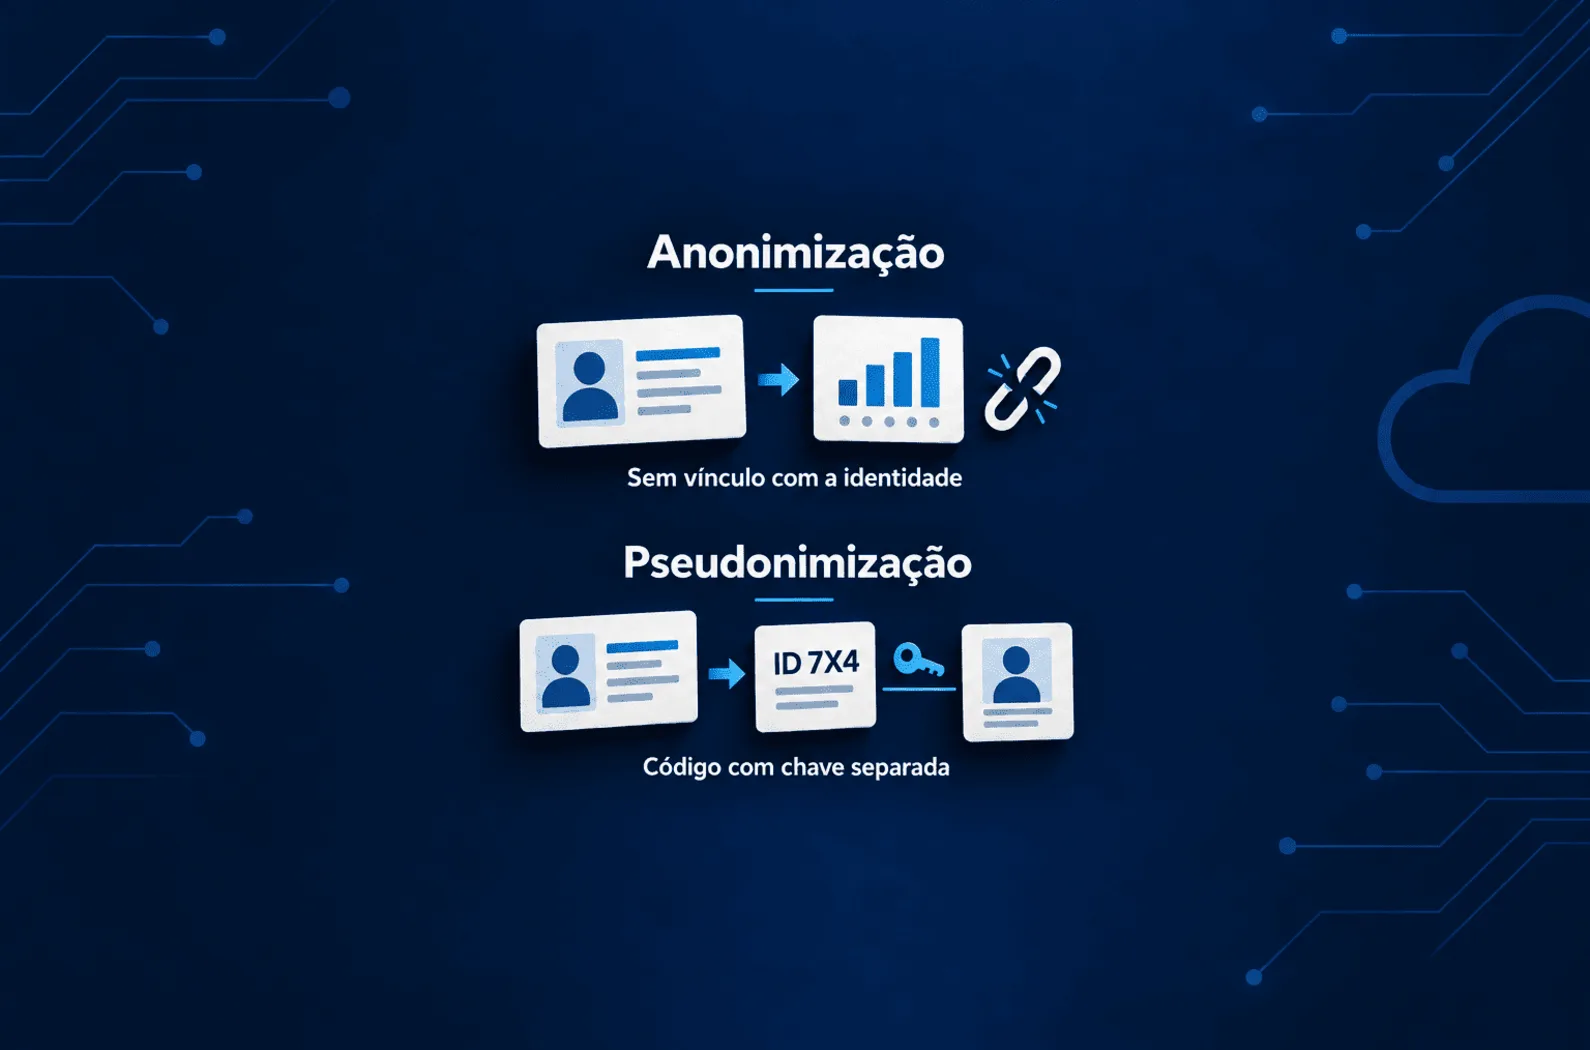
Anonimização e pseudonimização são técnicas diferentes, com consequências jurídicas diferentes. Um dado anonimizado, em regra, deixa de ser dado pessoal. Um dado pseudonimizado continua sendo dado pessoal e continua sujeito a todas as regras da lei. Confundir as duas coisas leva a compartilhamentos sem base legal, ambientes de teste cheios de dados reais e uma falsa sensação de segurança.
Este guia mostra o que a LGPD diz sobre cada conceito, quais técnicas existem, como avaliar o risco de reidentificação e como aplicar isso em BI, testes de software e compartilhamento de dados.
O que a LGPD diz sobre anonimização e pseudonimização
A lei define dado anonimizado como o dado relativo a um titular que não possa ser identificado, "considerando a utilização de meios técnicos razoáveis e disponíveis na ocasião de seu tratamento" (art. 5º, III). A anonimização é o uso desses meios para que o dado perca a possibilidade de associação, direta ou indireta, a um indivíduo (art. 5º, XI).
O art. 12 traz a consequência prática: dados anonimizados não são considerados dados pessoais, salvo quando o processo for revertido usando exclusivamente meios próprios ou quando puder ser revertido com esforços razoáveis. O § 1º diz que o razoável depende de fatores objetivos, como o custo e o tempo necessários para reverter o processo, de acordo com as tecnologias disponíveis. O § 2º acrescenta que dados usados para formar o perfil comportamental de uma pessoa identificada também podem ser considerados dados pessoais.
A pseudonimização aparece no art. 13, § 4º, dentro do artigo que trata de estudos em saúde pública. A lei a define como o tratamento pelo qual um dado perde a possibilidade de associação a um indivíduo, "senão pelo uso de informação adicional mantida separadamente pelo controlador em ambiente controlado e seguro". Apesar do contexto específico, o conceito é usado de forma ampla na prática e nos estudos técnicos da ANPD.
O ponto que mais importa está na última parte da definição: a informação adicional existe. Quem tiver acesso a ela consegue voltar à pessoa. Por isso o dado pseudonimizado continua sendo dado pessoal, já que a pessoa continua identificável (art. 5º, I). A pseudonimização reduz a exposição, mas não tira o tratamento do alcance da LGPD.
Pseudonimizar não tira o dado da LGPD
Uma base pseudonimizada continua precisando de base legal, finalidade definida, controle de acesso, prazo de retenção e registro no mapeamento de dados. O que muda é o nível de risco, não o regime jurídico.
A ANPD colocou em consulta pública, no início de 2024, a minuta de um guia sobre anonimização e pseudonimização, com contribuições recebidas até 14 de março daquele ano. Até a publicação deste artigo, a versão final não constava entre os guias orientativos disponíveis no site da ANPD, e o tema continua previsto na Agenda Regulatória 2025-2026, atualizada pela Resolução CD/ANPD nº 31/2025. Enquanto isso, as referências oficiais mais completas são os estudos técnicos sobre anonimização que a ANPD publicou em 2023, citados ao longo deste texto.
Qual a diferença entre anonimização e pseudonimização na prática
A pergunta que separa os dois conceitos é simples: alguém consegue voltar à pessoa com meios razoáveis? Se a empresa guarda uma tabela que liga o código ao cliente, ou se a combinação das informações que sobraram permite descobrir quem é quem, o dado não está anonimizado.
- Reversão: na pseudonimização, voltar à pessoa é possível e depende de uma informação guardada à parte; na anonimização, isso não deve ser possível com meios razoáveis.
- Status jurídico: o dado pseudonimizado continua sendo dado pessoal; o anonimizado, em regra, deixa de ser.
- Obrigações: a base pseudonimizada segue exigindo base legal, transparência, segurança e atendimento a direitos; a anonimizada fica fora dessas obrigações enquanto o risco de reidentificação continuar baixo.
- Utilidade: a pseudonimização preserva o vínculo entre registros da mesma pessoa; a anonimização quase sempre exige perda de detalhe.
- Uso típico: pseudonimização para análises internas, testes e processamento por fornecedores; anonimização para estatísticas, publicações e pesquisas que não precisam do vínculo com a pessoa.
Um detalhe costuma passar despercebido. A mesma base pode ser anônima para quem a recebe e continuar identificável para quem a gerou. Se a empresa envia a um parceiro uma planilha sem identificadores, mas guarda a base original e consegue ligar os registros de volta com meios próprios, para ela aquilo continua sendo dado pessoal (art. 12).
As conclusões do estudo técnico da ANPD com a análise jurídica da anonimização vão na mesma linha: o texto afirma que o ato inicial de anonimizar já é uma operação de tratamento sujeita à LGPD, que os conceitos de dado pessoal e dado anonimizado têm caráter dinâmico e contextual e que a avaliação deve seguir um modelo baseado em riscos.
Por que tirar o nome não basta: identificadores diretos e indiretos
Identificador direto é a informação que aponta para uma pessoa sem precisar de mais nada, como nome completo, CPF, e-mail pessoal ou número de telefone. Identificador indireto, também chamado de quase-identificador, é a informação que sozinha não identifica ninguém, mas que combinada com outras pode apontar para uma única pessoa: CEP, data de nascimento, gênero, cargo, idade, endereço IP.
O exemplo clássico, citado no estudo jurídico da ANPD, é uma pesquisa publicada em 2000 por Latanya Sweeney. Ela mostrou que 87% da população dos Estados Unidos tinha características provavelmente únicas considerando apenas o código postal de cinco dígitos, o gênero e a data de nascimento. Nenhuma dessas três informações identifica alguém sozinha. Juntas, identificam quase todo mundo.
Imagine uma planilha de RH enviada a uma consultoria para uma pesquisa salarial, sem nomes, mas com área, cargo, data de admissão e salário. Em uma área com duas pessoas no mesmo cargo, qualquer colega descobre quem ganha quanto. O exemplo é fictício, mas a situação aparece com frequência.
Campos de texto livre merecem atenção especial. Observações de atendimento, descrições de chamados e comentários em prontuários costumam trazer nomes, telefones e detalhes que nenhuma regra aplicada a colunas vai pegar. O mesmo vale para metadados de arquivos, imagens, gravações e logs.
Técnicas de pseudonimização mais usadas
A pseudonimização troca identificadores diretos por pseudônimos e guarda a forma de voltar em outro lugar, com acesso restrito. As técnicas mais comuns são estas.
Tokenização
O identificador é substituído por um valor aleatório, e a correspondência entre token e valor original fica em uma tabela ou serviço separado, sob controle de poucas pessoas. É a técnica mais simples de entender e de auditar. O cuidado principal é com a tabela de correspondência: se ela estiver no mesmo banco e com as mesmas permissões da base tokenizada, a proteção é quase nula.
Hash com chave secreta
Muita gente usa o hash de um CPF ou de um e-mail como pseudônimo. O problema do hash simples, sem chave, é que o CPF tem formato fixo e um número limitado de combinações possíveis. Quem tiver acesso à base consegue calcular o hash de todos os números possíveis e comparar os resultados, com recursos computacionais acessíveis. O mesmo raciocínio vale para telefones e datas de nascimento. Quando o hash for usado como pseudônimo, ele deve incluir uma chave secreta, como no HMAC, guardada fora da base, com controle de acesso e rotina de troca.
Criptografia
A criptografia protege o dado enquanto a chave estiver segura. Quem tem a chave lê tudo, o que coloca a criptografia mais perto da pseudonimização do que da anonimização. Ela continua sendo uma medida de segurança relevante: a LGPD prevê que, no juízo de gravidade de um incidente, será avaliada a comprovação de medidas técnicas que tornem os dados ininteligíveis para terceiros não autorizados (art. 48, § 3º).
Pseudônimos diferentes por destinatário
Uma decisão de desenho que ajuda bastante é usar pseudônimos diferentes para cada destinatário. Se o time de BI e um fornecedor externo recebem o mesmo código para o mesmo cliente, as duas bases podem ser cruzadas. Com pseudônimos por contexto, esse cruzamento fica bem mais difícil.
Técnicas de anonimização e seus limites
Anonimizar exige mais do que trocar identificadores. É preciso reduzir o detalhe das informações que sobram até que as combinações deixem de apontar para pessoas específicas. O estudo técnico da ANPD sobre processo baseado em risco e técnicas computacionais descreve ou menciona técnicas como estas:
- Generalização: substituir valores por categorias mais amplas, como a cidade pelo estado ou a idade por faixa etária.
- Supressão: retirar colunas, registros ou valores raros que tornariam alguém único na base.
- Mascaramento: trocar parte dos caracteres por símbolos, o que reduz a exposição, mas depende de um padrão consistente para não permitir a reconstrução do dado.
- Permutação: embaralhar valores entre registros, preservando totais e distribuições, mas impedindo a análise no nível do indivíduo.
- Adição de ruído: alterar levemente valores numéricos quando a precisão exata não é necessária para a finalidade.
- Desfoque e pixelização: aplicados a rostos e outras regiões de imagens e vídeos.
Para medir se o resultado ficou bom, a literatura técnica usa métricas como k-anonimato, l-diversidade e t-proximidade. Todas derivam da ideia de classe de equivalência: quantas pessoas compartilham a mesma combinação de atributos. Se a combinação de faixa etária, estado e cargo aparece para uma única pessoa, essa pessoa está exposta, mesmo sem nome.
A ANPD é direta sobre os limites. Segundo o estudo, não há técnica com eficácia plena, todas estão sujeitas a ataques de reidentificação e não é factível considerar que a anonimização resulte em risco zero. Muitas técnicas clássicas também foram pensadas para dados em tabelas e funcionam mal para imagens, áudio e dados gerados em fluxo contínuo. Por isso a orientação é tratar a anonimização como um processo contínuo baseado em risco, e não como a aplicação pontual de uma técnica.
Dados sintéticos, gerados para imitar as propriedades estatísticas da base real, ajudam principalmente em testes, mas também precisam ser avaliados: um gerador mal configurado pode reproduzir registros muito próximos dos reais.
Como avaliar o risco de reidentificação
Para avaliar esse risco, a ANPD propõe um processo em etapas: definir o risco de reidentificação aceitável para aquela base, aplicar as técnicas, medir o risco resultante e comparar. Se o risco medido ficar acima do aceitável, o conjunto não pode ser tratado como anonimizado e o processo recomeça. Se ficar abaixo, o uso precisa ser acompanhado, porque inclusões, alterações e exclusões de registros mudam o risco. Em bases públicas ou compartilhadas, o risco deve ser considerado maior.
Levado para a rotina de uma equipe de dados, esse processo pode seguir uma sequência como esta:
- Defina a finalidade e o nível de detalhe que ela realmente exige.
- Classifique cada campo como identificador direto, identificador indireto, dado sensível ou atributo comum.
- Escolha as técnicas para cada tipo de campo e aplique em uma cópia controlada.
- Meça o risco, procurando combinações únicas e grupos pequenos.
- Considere quem vai receber a base, o que essa pessoa já sabe e se a base será publicada.
- Documente as decisões e marque uma data para reavaliar.
A documentação registra quais técnicas foram usadas, com quais parâmetros, quem aprovou e com base em que medição. Guardar também as propriedades estatísticas da base original ajuda a perceber quando a perda de qualidade inviabiliza a finalidade, um ponto que o estudo da ANPD também destaca.
Uma base anonimizada hoje pode deixar de ser anonimizada amanhã, se novos dados forem incluídos ou se surgirem outras bases que permitam o cruzamento. Registre a avaliação, o responsável e a data da próxima revisão.
Exemplos práticos: BI, testes de software e compartilhamento
Painéis de BI e relatórios gerenciais
Na maioria dos painéis, ninguém precisa ver o cliente individual. Totais por região, faixa etária ou produto atendem à finalidade. Nesses casos, a base de BI pode receber dados já agregados, e células com poucos registros podem ser suprimidas para evitar que um número pequeno revele uma pessoa. Quando a análise precisa acompanhar a mesma pessoa ao longo do tempo, como em estudos de retenção de clientes, a pseudonimização com um token estável resolve, desde que a tabela de correspondência não fique acessível ao time de análise.
Ambientes de teste e homologação
Copiar a base de produção para o ambiente de testes é um dos hábitos mais arriscados em engenharia. Esses ambientes costumam ter mais pessoas com acesso, menos monitoramento e integrações com ferramentas de terceiros. O caminho mais seguro é usar dados sintéticos ou bases pseudonimizadas e mascaradas, com e-mails e telefones substituídos para evitar o envio acidental de mensagens a clientes reais. Para levar esse cuidado ao ciclo de desenvolvimento, veja nosso artigo sobre Privacy by Design no ciclo de desenvolvimento de software (SDLC).
Compartilhamento com parceiros e pesquisa
A LGPD pede a anonimização, sempre que possível, nos estudos feitos por órgãos de pesquisa (arts. 7º, IV, e 16, II). No compartilhamento com parceiros comerciais, a primeira pergunta é se o parceiro precisa de dados individuais. Se não precisa, envie agregados. Se precisa, trate como compartilhamento de dados pessoais, com base legal, contrato e registro. Quando a empresa concluir que a base enviada está anonimizada, é uma boa prática incluir no contrato a proibição de tentar reidentificar os registros ou de cruzá-los com outras bases.
Erros comuns ao anonimizar ou pseudonimizar dados
- Chamar de anonimizada uma base da qual só o nome foi retirado.
- Usar hash simples de CPF, e-mail ou telefone como se fosse irreversível.
- Guardar a tabela de correspondência no mesmo banco e com as mesmas permissões da base pseudonimizada.
- Esquecer campos de texto livre, anexos, imagens e logs.
- Repetir o mesmo pseudônimo em bases enviadas a destinatários diferentes.
- Fazer a avaliação de risco uma vez e nunca mais revisar.
Onde a anonimização entra no ciclo de vida do dado
A anonimização também aparece como alternativa ao descarte. A LGPD autoriza a conservação de dados após o fim do tratamento para uso exclusivo do controlador, vedado o acesso por terceiros, desde que anonimizados (art. 16, IV). O titular, por sua vez, pode pedir a anonimização de dados desnecessários, excessivos ou tratados em desconformidade com a lei (art. 18, IV). A escolha entre apagar, bloquear, anonimizar ou manter tem critérios próprios, que detalhamos no artigo sobre eliminação de dados na LGPD.
Há também um efeito prático em incidentes de segurança. Segundo a página da ANPD sobre comunicação de incidentes, incidentes que envolvam somente dados anonimizados não precisam ser comunicados à agência. A mesma página lista, entre os fatores da avaliação de risco, se os dados atingidos estavam protegidos de forma a impossibilitar a identificação dos titulares. Uma base pseudonimizada, com a chave bem guardada, tende a pesar menos nessa avaliação do que uma base aberta, mas continua sendo dado pessoal e entra na análise.
Como a LGPD Cloud pode ajudar a manter esse controle
Em uma empresa pequena, dá para controlar tudo isso com uma planilha que liste as bases derivadas, as técnicas aplicadas e as datas de revisão. A dificuldade aparece quando a mesma informação passa a existir em vários lugares: o data warehouse, o ambiente de homologação, a base enviada ao parceiro, o extrato usado em uma pesquisa. Cada cópia tem um nível de proteção diferente e, muitas vezes, um responsável diferente.
Na LGPD Cloud, o Mapeamento de Dados registra, para cada atividade de tratamento, os sistemas usados, os métodos de armazenamento, os compartilhamentos com terceiros e o tempo de retenção. É ali que a equipe pode indicar, por exemplo, que a atividade de análise de vendas usa uma base pseudonimizada em um ambiente de BI e que um extrato agregado é compartilhado com um parceiro.
Quando a anonimização é a destinação no fim do ciclo, o módulo de Eliminação de Dados permite registrar a operação indicando anonimização como método, as categorias de dados envolvidas, o volume, o status e as evidências anexadas, como relatórios de sistema. Os riscos de reidentificação apontados na avaliação podem entrar na Gestão de Riscos, com nível, estratégia de tratamento e plano de ação, e os casos mais delicados podem ganhar um RIPD com matriz de riscos, medidas de controle e risco residual. A plataforma não aplica as técnicas nos seus sistemas; ela ajuda a manter registrado o que foi decidido, por quem e quando revisar.
Conclusão: comece pela finalidade, não pela técnica
Antes de escolher uma técnica, pergunte para que a base será usada e quem vai acessá-la. Se a finalidade exige acompanhar pessoas, o caminho é a pseudonimização, com a chave bem guardada e todas as obrigações da LGPD mantidas. Se a finalidade se resolve com informação sobre grupos, a anonimização pode ser viável, desde que o risco de reidentificação seja medido, documentado e revisto.
Nenhuma técnica elimina o risco por completo, e a própria ANPD reconhece isso. O que dá segurança é saber quais bases derivadas existem, como cada uma foi tratada e quando cada avaliação precisa ser refeita.
Fontes oficiais para aprofundamento
Consulte o texto compilado da LGPD, especialmente os artigos 5º, 12, 13, 16, 18 e 48, e a página de documentos técnicos da ANPD, onde estão os estudos técnicos sobre anonimização publicados em 2023. A situação do tema na regulação pode ser acompanhada pela Resolução CD/ANPD nº 31/2025, que atualizou a Agenda Regulatória 2025-2026.